Engenharia
Qualidade de software no mundo de agentes de código
- Agentes de programação
- Qualidade de software
- Produtividade
- Revisão de código
- Testes de software
- Guardrails
- Observabilidade
- Operação e deploy
- Produto e experiência do usuário
- Engenharia de plataforma
- Fábricas de software
Agentes de código estão mudando a maneira como fazemos engenharia de software. E se a maneira de produzir software mudou, nossas práticas de qualidade também precisam mudar. Algumas precisam de ajustes. Outras precisam ser repensadas com bastante cuidado, porque foram construídas para um mundo em que humanos escreviam código em uma velocidade muito menor.
É fato que escrever código ficou muito mais fácil. Garantir que esse código funcione, continue funcionando e resolva um problema de verdade para o usuário continua sendo o nosso trabalho. Ensinar o agente a garantir que o código funcione e que continue funcionando é o nosso trabalho do futuro.
Como garantir a qualidade do software que os agentes estão construindo para nós?
Desde quando tudo era mato…
Quando cheguei à TU Delft para fazer meu pós-doutorado, meu plano era pesquisar qualidade de software. Mas, sem querer, fui parar em um grupo que já pensava muito sobre inteligência artificial aplicada à engenharia de software. Isso foi em 2016. Bem antes de termos um chat em que bastava escrever “implemente isso aqui pra mim”. Na verdade, o paper da Google sobre transformers, a arquitetura de redes neurais que nos permitiu a criação das LLMs modernas, foi publicado só em 2017.
Havia pouca dúvida, naquele grupo de pesquisa, de que o computador assumiria cada vez mais tarefas operacionais de um desenvolvedor. Gerar dados para um teste. Recomendar uma refatoração. Ajudar a encontrar um defeito. Entender onde colocar um log. O trabalho era descobrir como fazer isso funcionar.
Investigamos geração de dados de teste para consultas SQL e remodularização de software com algoritmos de busca, exploramos aprendizado de máquina para prever refatorações, recomendar onde colocar logs e recomendar extrações de métodos. Também estudamos erros de off-by-one com deep learning. Eram maneiras diferentes de tentar automatizar partes do trabalho de engenharia.
Tudo isso exigia bastante pesquisa. Você precisava formular o problema de um jeito que o algoritmo entendesse, encontrar ou construir dados, escolher técnicas, implementar a solução e avaliar se ela servia para alguma coisa fora do experimento. Às vezes, anos de trabalho para automatizar uma tarefa bastante específica.
As LLMs democratizaram e simplificaram muito esse processo. Hoje você pode pedir a um agente que leia uma implementação, escreva testes, execute esses testes, investigue as falhas e tente novamente. Em linguagem natural. Sem precisar entender como treinar uma rede neural ou implementar um algoritmo de busca.
Isso não significa que qualquer problema de pesquisa foi resolvido por um prompt. Mas muita coisa que antes exigia uma ferramenta especializada e anos de pesquisa passou a estar ao alcance de qualquer desenvolvedor. A ambição de automatizar tarefas de engenharia já existia. O que mudou radicalmente foi quem consegue fazer isso, com que facilidade e em quantas tarefas ao mesmo tempo.
A engenharia de software agêntica veio para ficar
O período em torno de dezembro de 2025 marcou mais uma virada na revolução da IA. Os agentes começaram a ficar muito mais úteis para executar trabalho de verdade: explorar uma base, alterar vários arquivos, usar ferramentas e continuar trabalhando até chegar a um resultado. Para muita gente, a experiência deixou de ser pedir uma sugestão de código ou tirar uma dúvida (o que chamávamos de inteligência artifical generativo) e passou a ser delegar uma tarefa e deixar inclusive que o agente tomar decisões de maneira autônoma (a inteligência artificial agêntica).
Já temos exemplos concretos disso em produção. A Stripe descreve seus Minions como agentes que recebem uma tarefa e produzem mudanças completas, com revisão humana antes do merge. O ponto interessante do relato é quanto trabalho existe ao redor do modelo: ambiente, contexto, ferramentas e verificações. Na Alura, também contamos nossa experiência de adoção no Hipsters.tech sobre engenharia agêntica. Isso já faz parte do trabalho de times de engenharia.
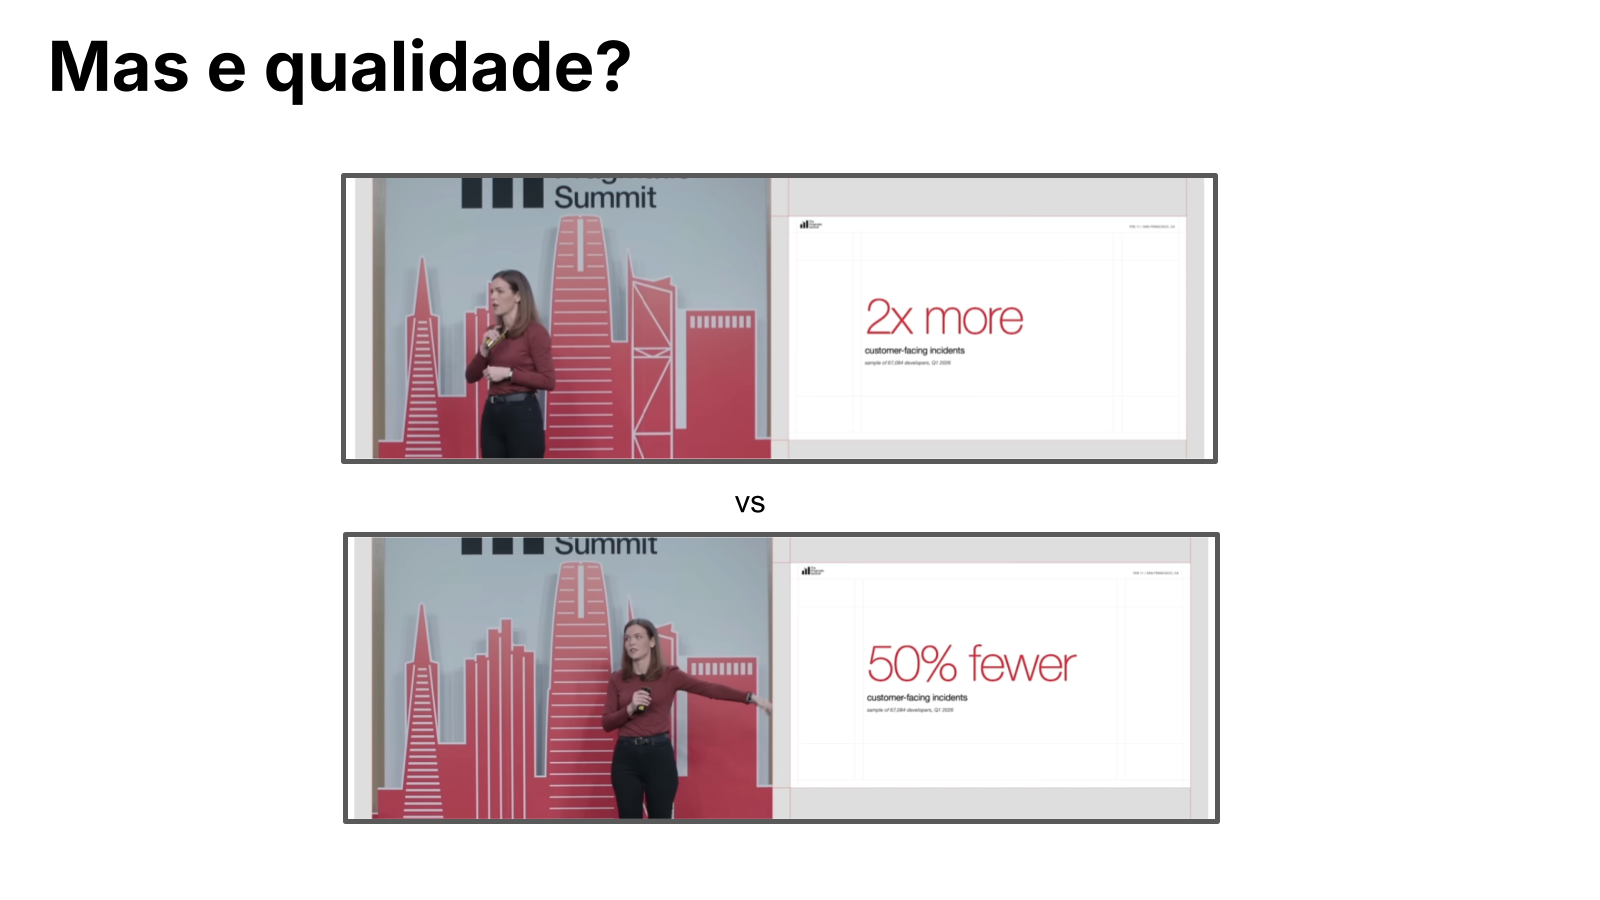
Os dados de produtividade também são difíceis de ignorar. Os benchmarks da DX, compartilhados por Laura Tacho no Pragmatic Summit, de março de 2026, mostram economia de tempo para desenvolvedores, uma parcela relevante do código já escrita com IA e redução no tempo de onboarding. Há ganho real acontecendo.
Mas e a qualidade?
Os mesmos dados da DX mostram organizações com metade dos incidentes que afetam clientes e organizações com o dobro desses incidentes. Vale ser preciso aqui: o indicador é de incidentes percebidos por clientes, e não uma contagem de todos os bugs da base. Ainda assim, o contraste é enorme. Usar IA não determina, sozinho, de qual lado você vai ficar.
Até a Anthropic tem problemas de qualidade no próprio produto. No relato sobre regressões do Claude Code em abril de 2026, a empresa explica como mudanças no esforço de raciocínio, no gerenciamento de contexto e nas instruções do sistema afetaram a qualidade percebida pelos usuários. Uma das falhas fazia a limpeza de parte do histórico acontecer repetidamente, em vez de uma vez só. As avaliações e o uso interno não capturaram inicialmente todos os problemas.
O Addy Osmani resume bem essa mudança de foco em Agentic Verification: o gargalo se desloca da escrita para a verificação.
Minha leitura é que precisamos investir tanta energia em criar mecanismos para o agente descobrir que errou quanto investimos em fazê-lo escrever mais código. Guardrails e verificação precisam acompanhar o ganho de produtividade que temos com a automatização da escrita do código.
Nossa capacidade de confiar precisa crescer junto
O Kent Beck fez uma provocação que ficou na minha cabeça: estamos acumulando código mais rápido do que confiança. Ele lembra que nosso trabalho sempre produziu as duas coisas. Cada melhoria necessária e cada deploy seguro também construíam confiança no sistema.
Ele aponta três caminhos: aprender a viver com menos confiança, reduzir a produção de código ou aprender a construir confiança mais rapidamente.
Eu quero trabalhar no terceiro.
Para sermos mais eficientes, precisamos escalar ainda mais o uso de IA. Precisamos conseguir delegar tarefas maiores, deixar agentes trabalharem por mais tempo e tirar o humano de várias etapas operacionais. Mas isso só funciona se nossa capacidade de verificar o resultado crescer junto.
Hoje, muitas vezes, o agente diz “terminei”“e nós começamos uma segunda jornada para descobrir se ele terminou mesmo. Subimos a aplicação, exercitamos a funcionalidade, encontramos um problema óbvio, mandamos de volta. O agente corrige, diz que terminou novamente, e repetimos o processo. Enquanto isso for necessário para toda mudança, nossa capacidade de atenção será o limite do sistema.
Queremos (e precisamos!) chegar a um ponto em que, se o agente diz que funciona, temos bons motivos para acreditar que funciona. Esses motivos precisam ser observáveis: testes executados, comportamento verificado, restrições respeitadas, resultado inspecionável. E precisamos saber também o que ele não conseguiu verificar.
Confiança se constrói com evidência e com um histórico de que essas evidências são úteis. Se um agente sempre apresenta uma suíte verde que deixa passar problemas básicos, aquele verde vale pouco. Se as verificações pegam defeitos reais e o software se comporta bem em produção, podemos ampliar sua autonomia com mais segurança.
A autonomia dos agentes precisa crescer junto com nossa capacidade de verificar o que eles entregam. Essa é a ideia que conecta todas as práticas a seguir.
Qualidade de código
Vamos começar tirando um viés da frente: a IA escreve, sim, código de qualidade.
É bastante comum ouvir que o código da máquina é feio, cheio de gambiarras, difícil de manter. Às vezes é mesmo. E talvez isso até fosse mais verdade em versões mais antigas dos modelos de IA. Já vi o Haiku escrevendo código que eu considerei “feio”.
Mas, vamos ser honestos: você já viu código escrito por humanos? A verdade é que sempre achamos o código escrito pelo outro, feio. E agora temos mais um “outro” para colocar nessa categoria. Só que subimos a barra justamente por esse outro ser uma máquina.
Vi uma provocação da Lauren, que escreve como @poteto, que cai bem. Ela comenta que bases de código sempre tiveram imperfeições e que software muda continuamente. Ela questiona a nossa nostalgia de uma base humana supostamente impecável e enfatiza características práticas, como correção e custo de execução.
O Dave Farley discutiu um experimento sobre isso. Um grupo de participantes escreveu código com ou sem IA; outro grupo precisou evoluir esse código sem saber sua origem. Segundo o relato dele, não houve diferença significativa no custo de manutenção entre os grupos. A interpretação do Dave é que a IA amplifica a disciplina de engenharia de quem a usa. Esse resultado não encerra a discussão sobre manutenção de longo prazo, mas ajuda a questionar a ideia de que código gerado por IA é necessariamente pior.
Muitos estudos tentam entender o impacto de agentes na qualidade de código. Eu fiz uma síntese sobre os estudos publicados na MSR 2026. Lá, reuni resultados que mostram tanto a capacidade dos agentes quanto problemas que merecem atenção. Foi um artigo gerado 100% por IA, já que meu objetivo era resumir os mais de 60 artigos publicados, mas vale a leitura.
Um bom número de trabalhos mostra que o agente, sem os guardrails corretos, ignora algumas das boas práticas de engenharia de software que conhecemos há décadas. Os achados, como todo trabalho científico, precisam ser lidos no contexto das versões, tarefas e repositórios analisados. Mas minha leitura desses resultados é que precisamos medir a qualidade que queremos preservar: reúso, simplicidade, manutenção e comportamento correto. A IA consegue produzir bom código, mas precisamos dar a ela critérios e mecanismos para verificar essas propriedades.
A IA é particularmente boa em repetir padrões. Mostre uma boa implementação de uma funcionalidade parecida, explique as convenções do projeto e dê acesso ao contexto necessário. Ela consegue aplicar esse padrão em outros lugares com uma consistência bastante útil. Naturalmente, também consegue repetir os padrões ruins que encontrar na sua base. Por isso, cuidar dos exemplos que ela vai copiar importa tanto.
Uma outra vantagem que percebo na prática dia após dia é que ela também consegue explorar funcionalidades de frameworks que nós talvez nem conheçamos. No nosso relato da migração do Spring Boot 2 para o 4 na Alura, o agente conhecia quais as dependências, configurações, APIs de data e hora, consultas do Hibernate que precisavam mudar e configuração de segurança, coisas que duvido que algum desenvolvedor, por mais sênior que fosse, saberia responder de cabeça. Ter alguém capaz de percorrer essas mudanças e consultar as alternativas disponíveis evita bastante trabalho manual e pode evitar gambiarras feitas por falta de conhecimento do framework.
Mas o agente precisa entender o que “bom código” significa para o seu time. Quais são os limites entre módulos? Onde uma regra de negócio deve ficar? Quais abstrações já existem? Quais dependências são aceitáveis? O que precisa continuar simples?
A Anthropic discute isso no texto sobre engenharia de contexto: o comportamento depende do conjunto de informações disponível ao modelo, e esse conjunto precisa ser selecionado e mantido. Minha aplicação prática dessa ideia é explicitar as decisões do time, oferecer bons exemplos e transformar as restrições importantes em verificações sempre que possível.
A responsabilidade pela qualidade do código continua sendo nossa. É o nosso time que escolhe o contexto, mantém a base e decide o que entra em produção. Dizer “foi o agente que escreveu esse código feio” não resolve nada para quem vai manter o sistema.
Também precisamos entender onde essa qualidade importa mais. Um protótipo descartável e o núcleo de um sistema que movimenta dinheiro pedem cuidados diferentes. Precisamos escolher conscientemente onde investir em estrutura, legibilidade e evolução. E avaliar a solução pelos requisitos e pelo contexto em que ela vai viver. A origem humana ou artificial do código, por si só, diz muito pouco.
Revisão de código
Revisão de código virou um dos gargalos mais visíveis nesse novo mundo.
O Praveen Neppalli contou que a Uber já produzia 1.800 mudanças por semana com seu agente interno, mas ainda com engenheiros revisando e aprovando o resultado. É uma demonstração interessante de adoção: a escrita pode ser inteiramente agêntica e, mesmo assim, a saída continuar dependendo de uma fila humana.
Se todo ganho na geração de código termina nessa fila de revisão de código, temos um problema. Um desenvolvedor pode disparar várias tarefas em paralelo, mas continua tendo apenas uma cabeça para ler o resultado. Precisamos trabalhar para precisar cada vez menos dessa leitura manual.
Outros influenciadores de tecnologia também ainda veem valor na revisão de código. O DHH compartilhou uma orientação para mudanças feitas por designers no Basecamp: usar IA para prototipar era bem-vindo, mas integrar essas mudanças à aplicação exigia revisão de um programador. A preocupação dele é preservar a arquitetura e a capacidade de continuar evoluindo o produto. O Guillermo Rauch também observa que os modelos ainda cometem erros básicos e tomam caminhos arquiteturais ruins.
Por outro lado, o Robert C. Martin, o Uncle Bob, descreveu uma abordagem diferente: deixar o código com a IA e acompanhar cobertura, estrutura de dependências, complexidade, tamanho dos módulos e testes de mutação. A proposta dele é deslocar a supervisão para verificações que consigam dar feedback ao agente automaticamente.
Uncle Bob descreve como usa métricas e testes para acompanhar o código produzido por agentes.
Veja o post de Robert C. Martin
São posições diferentes, ligadas a contextos e níveis de confiança diferentes. Para mim, a direção é clara: precisamos aumentar o que conseguimos verificar automaticamente e reservar o julgamento humano para as mudanças em que ele realmente faz diferença. Uma métrica isolada não vai nos dizer se uma funcionalidade resolve o problema certo. Mas também não faz sentido gastar tempo humano apontando algo que uma ferramenta consegue verificar em segundos.
A Rachel Laycock questiona justamente quantas responsabilidades acumulamos no code review: encontrar bugs, ensinar, compartilhar conhecimento, garantir arquitetura, criar propriedade coletiva. Ela propõe antecipar essas conversas e usar revisão humana por exceção. Programação pareada de volta a moda, do jeito que os entusiastas de Programação Extrema gostam.
De maneira pragmática, se não conseguimos revisar todas as mudanças de código, recisamos priorizar o que realmente precisa ser revisado.
Um ponto de partida para o time discutir é:
| Risco da mudança | Revisão proposta |
|---|---|
| Baixo | Revisão por IA e verificações automáticas suficientes para aquele contexto. |
| Médio | Revisão por IA, com participação humana quando surgirem dúvidas ou sinais de risco. |
| Alto | Revisão por IA e revisão humana obrigatória. |
O risco depende do que muda e do impacto possível, não apenas do tamanho do diff. Poucas linhas em uma autorização podem merecer muito mais atenção do que uma alteração extensa e mecânica.
O Will Larson descreve uma implementação concreta dessa ideia na Imprint. A classificação de uma mudança como small-change depende de critérios verificados pelo sistema, como escopo, achados da revisão automática e experiência do autor naquela parte da base. Bibliotecas compartilhadas e áreas sensíveis têm restrições próprias. Também revisam grupos de PRs para encontrar temas recorrentes e oportunidades de melhorar as verificações. O que me interessa nesse exemplo é transformar a priorização em uma política explícita, executável e ajustável.
Outro ajuste importante é colocar a responsabilidade pela primeira verificação em quem produz a mudança. Só “digitar o prompt e apertar enter” e depois passar a responsabilidade de garantir que o código funciona para o revisor é péssimo. Esse fenômeno, aliás, acontece também fora de programação. O Tobias Lütke falou sobre o problema das “slop grenades”: trabalho produzido por IA e repassado sem ser verificado, deixando para outra pessoa o esforço de encontrar os erros. A responsabilidade por garantir que a mudança funcione é do autor da mudança.
O agente deve concluir seu trabalho com evidências claras de que a mudança de código funciona. Quais testes executou, quais cenários exercitou, o que observou e o que ficou pendente. E o humano que está entregando aquele trabalho continua responsável por isso. O revisor pode aprofundar a análise; ele não deveria precisar começar a validação do zero.
Finalmente, revisão de código passa a ser também revisão da fábrica. Se encontramos um problema, precisamos perguntar o que mudar para o agente não repeti-lo. Faltou uma instrução? Um exemplo? Uma restrição de arquitetura? Uma ferramenta?
O Brian Scanlan mostra uma prática nessa direção: verificar e atualizar periodicamente os arquivos de instruções e suas referências, além de ajustar agentes de revisão para trazer apenas feedback importante. É manutenção do ambiente que produz o código.
Corrigir um diff resolve a entrega de hoje. Melhorar a fábrica pode resolver uma classe de problemas nas próximas entregas. É aí que eu quero colocar cada vez mais da energia de revisão.
Testes automatizados
A IA escreve testes. Bastante. E isso é ótimo: testes dão feedback rápido e barato para o próprio agente durante a implementação. Podemos pedir que ele cubra casos de erro, explore condições de fronteira e transforme bugs encontrados em testes de regressão. Muita coisa que antes ficava para depois agora custa bem menos esforço.
Só que a IA também é especialista em escrever testes que passam e não testam nada de relevante.
Ela testa a implementação em vez da funcionalidade. Cria mocks que devolvem exatamente o que o teste espera. Repete o mesmo cenário com pequenas mudanças cosméticas. Faz uma asserção tão fraca que praticamente qualquer implementação passaria. E depois nos apresenta uma cobertura bonita.
O problema fica ainda mais interessante quando o mesmo agente escreve o código e o teste. Se ele entendeu a regra de negócio errado, pode colocar o mesmo erro nos dois lugares. A implementação faz a coisa errada, o teste confirma aquela coisa errada e temos uma suíte inteira verde. Não à toa revisão de código adversarial, onde a revisão do código é feita por um modelo completamente diferente, tem ficado cada vez mais popular.
Imagine que uma compra cancelada deva gerar um reembolso. O agente implementa apenas a mudança de status e escreve um teste que verifica que o status mudou. O teste pode estar tecnicamente correto e ser útil para uma parte do comportamento. Mas ele não verifica que o dinheiro voltou. Uma decisão errada sobre o que precisava ser feito contaminou tanto a implementação quanto a avaliação.
Precisamos explicar para o agente o que é um bom teste e, principalmente, oferecer requisitos e resultados esperados que não sejam apenas uma cópia do código recém-escrito. Que comportamento importa para o usuário? Quais efeitos precisam aparecer no banco ou em uma integração? Que erro faria o teste falhar? Se retirássemos uma parte importante da implementação, alguém perceberia?
Precisamos também definir como o agente sabe que terminou. Quais comandos ele deve executar? Como sobe a aplicação? Como prepara dados? Quais fluxos precisa exercitar? Onde encontra o resultado? O Addy Osmani defende esse ciclo de auto-verificação: o agente implementa, executa uma checagem, lê a saída, corrige e repete antes de pedir atenção humana. Os testes passam a ser uma maneira de ele observar o próprio trabalho.
Outra mudança é que, até então, conseguíamos confiar muito em testes de unidade. Eles eram baratos de serem escritos, e nós humanos, conseguíamos desenhar bem as interfaces de comunicação entre as unidades. Com os agentes escrevendo tanto o código quanto os testes, mesmo delegando para outro modelo a escrita do teste para evitar viés, o teste de unidade me dá menos certeza de que tudo funciona.
Só testes de unidade não serão suficientes. O ciclo de qualidade em um mundo agêntico precisa incluir testes próximos do mundo real.
O Boris Cherny comentou que os bugs das LLMs estão mudando: menos erros locais de lógica e mais problemas de desenho do sistema, usabilidade e falta de contexto amplo. Ele também destaca a revisão adversarial como uma ferramenta útil para encontrar esses defeitos.
Boris Cherny discute bugs ligados a desenho de sistemas, usabilidade e falta de contexto nas implementações feitas com LLMs.
Veja o post de Boris Cherny
Agentes de código estão escrevendo muito menos “bugs estúpidos”, nas quais os testes de unidade são especialistas em pegar.
Testes de componente, integração e end-to-end ganham ainda mais importância. Queremos subir o sistema, usar um banco de verdade quando fizer sentido, atravessar fronteiras entre módulos e observar os efeitos de uma ação. No exemplo da compra, executar o cancelamento e verificar o pedido, o reembolso e a notificação é uma evidência muito mais próxima do que precisamos entregar.
Isso não exige que cada teste use toda a infraestrutura de produção. Exige escolher fronteiras que preservem o comportamento importante. E dá trabalho criar esses ambientes. Por isso, o time de plataforma precisa oferecer infraestrutura para o agente testar: ambientes isolados, dados reproduzíveis, comandos claros e acesso aos resultados.
Os testes de unidade continuam úteis. Dão feedback rápido, ajudam com regras locais e são baratos de executar. Mas vale revisitar a sua própria pirâmide de testes à luz do custo atual das ferramentas e dos defeitos que estamos encontrando. A distribuição da suíte deve nos ajudar a descobrir problemas reais.
Observabilidade, rollouts parciais e feature flags
Vamos colocar muito mais software em produção, muito mais rápido. E parte dele vai quebrar. Sempre colocamos código com defeito em produção; agora o volume e a velocidade tornam ainda mais importante descobrir rapidamente quando isso aconteceu e limitar o impacto.
O Chris Evans relatou uma experiência interessante na incident.io: estavam entregando três vezes mais código, enquanto a taxa de incidentes por mudança caiu de cerca de 1,4% para 0,82%. Uma queda significante.
Ele atribui parte da melhora às ferramentas de código e revisão. Mas faz uma distinção importante entre defeitos que podem ser encontrados olhando a implementação e defeitos que só se manifestam quando o código encontra as condições reais de produção. Conforme as ferramentas pegam mais problemas da primeira categoria, os da segunda ganham peso.
Isso conecta diretamente com nossa necessidade de observabilidade. Uma aplicação pode ter passado por todas as verificações e ainda falhar com dados, volume, concorrência, dependências ou configurações que não reproduzimos antes do deploy. Precisamos de logs, métricas e traces que ajudem a entender esses problemas, e também de sinais do comportamento que interessa para o negócio.
Uma API responder 200 não significa que o usuário conseguiu comprar. Um processo terminar sem exceção não significa que ele produziu o resultado correto. Observar o sistema exige escolher sinais que nos digam se as tarefas estão dando certo.
Também precisamos diminuir o tamanho de um eventual estrago. Feature flags permitem controlar a exposição de uma funcionalidade. Rollouts parciais permitem observar uma mudança com uma parte do tráfego antes de ampliá-la. Rollback automatizado permite interromper uma regressão sem depender de alguém perceber o problema e começar uma investigação manual.
O trabalho de Luiz Henrique de Souza, do iFood, apresentado no CBSoft 2026, sobre Deploy Canário com Guardrails Automatizados, traz um exemplo concreto no iFood. O fluxo começa com uma pequena exposição, monitora a saúde da mudança e só aumenta o tráfego quando os critérios definidos continuam satisfeitos. Quando não continuam, aborta a expansão. O que quero destacar é a verificação acontecendo durante a entrega, com critérios que o sistema consegue aplicar.
Esses mecanismos precisam fazer parte do caminho normal de deploy. Se cada equipe tiver que reinventá-los para cada funcionalidade, dificilmente acompanharão a velocidade com que estamos produzindo mudanças.
A IA pode ajudar até na operação e recuperação de incidentes. A Datadog apresenta o Bits AI SRE como um agente para investigar alertas, correlacionar sinais e explorar hipóteses de causa. É uma aplicação bastante natural de agentes: reunir logs, métricas, mudanças recentes e contexto do sistema para ajudar quem está de plantão.
Estamos voltando a uma daquelas tarefas que o grupo de pesquisa já imaginava automatizar anos atrás. Só que agora o agente pode ir além de ler um log: consegue investigar, comparar hipóteses e usar ferramentas. Para isso, precisa ter acesso a bons sinais e a um ambiente em que consiga trabalhar. Observabilidade também é infraestrutura para os agentes.
UX e UI
Qualidade vai muito além de o código funcionar.
Podemos ter testes passando, arquitetura organizada, deploy seguro e um produto que ninguém gosta de usar. Que exige cliques demais. Que não explica o que está acontecendo. Que apresenta cinquenta opções quando o usuário precisa de uma. Que funciona, mas é desagradável.
O DHH falou sobre a importância de beleza e estética na construção de produtos e afirmou que a experiência de conviver com coisas bem feitas importa: a beleza influencia como nos sentimos ao usar a tecnologia. Isso amplia a discussão de qualidade para além de uma lista de funcionalidades implementadas.
O Ethan Eismann, CDO da Nubank, desenvolve uma ideia parecida em Taste is what doesn’t change. Ele destaca dois momentos de julgamento: escolher o que merece ser construído e refinar o que foi construído até chegar a uma experiência excepcional. As ferramentas mudam, mas essas decisões continuam exigindo critério. Ele também trata bom gosto como algo que podemos cultivar, com atenção, repertório e prática.
Esse ponto me parece fundamental. Criar uma primeira versão ficou fácil. Escrever código não é mais diferencial competitivo de mercado. O difícil é perceber o que ainda está ruim e continuar trabalhando até ficar bom. Saber que aquela tela tem informação demais. Que a mensagem de erro não ajuda. Que a interação está correta, mas cansativa. Que uma funcionalidade inteira talvez nem devesse existir.
Não basta pedir ao agente que “deixe mais bonito” e aceitar a primeira resposta. Precisamos usar o produto, comparar alternativas, observar pessoas tentando realizar uma tarefa e desenvolver a capacidade de reconhecer uma experiência boa. A IA permite explorar e iterar muito mais; precisamos saber avaliar essas iterações.
Todo mundo que participa da criação de software vai precisar aprender mais sobre criar produtos encantadores. Engenharia, produto, design. Quando implementar uma ideia fica barato, escolher uma boa ideia e cuidar da experiência fazem ainda mais diferença.
Fábricas de software são o futuro próximo
Junte todas essas partes e fica mais claro para onde estamos indo.
O Chris Kelly descreve uma fábrica de software como um sistema de ciclos de trabalho, com agentes, pessoas, ferramentas, contexto e verificação. Seu argumento é que melhorar apenas a escrita individual deixa intactas as filas de planejamento, revisão e entrega. Para ampliar o ganho do time, precisamos melhorar o sistema por onde o trabalho passa. Ele sugere começar por um ciclo que já seja um gargalo, como ir de um PR até o merge ou de um alerta até sua resolução.
O Gergely Orosz mostra um exemplo desse desenho dentro da OpenAI. O relato conecta geração de código, integração contínua, revisão por agentes, classificação de risco, revisão humana quando necessária, deploy e acompanhamento de produção. O agente continua participando depois de escrever a implementação, e sinais de produção podem iniciar novas correções.
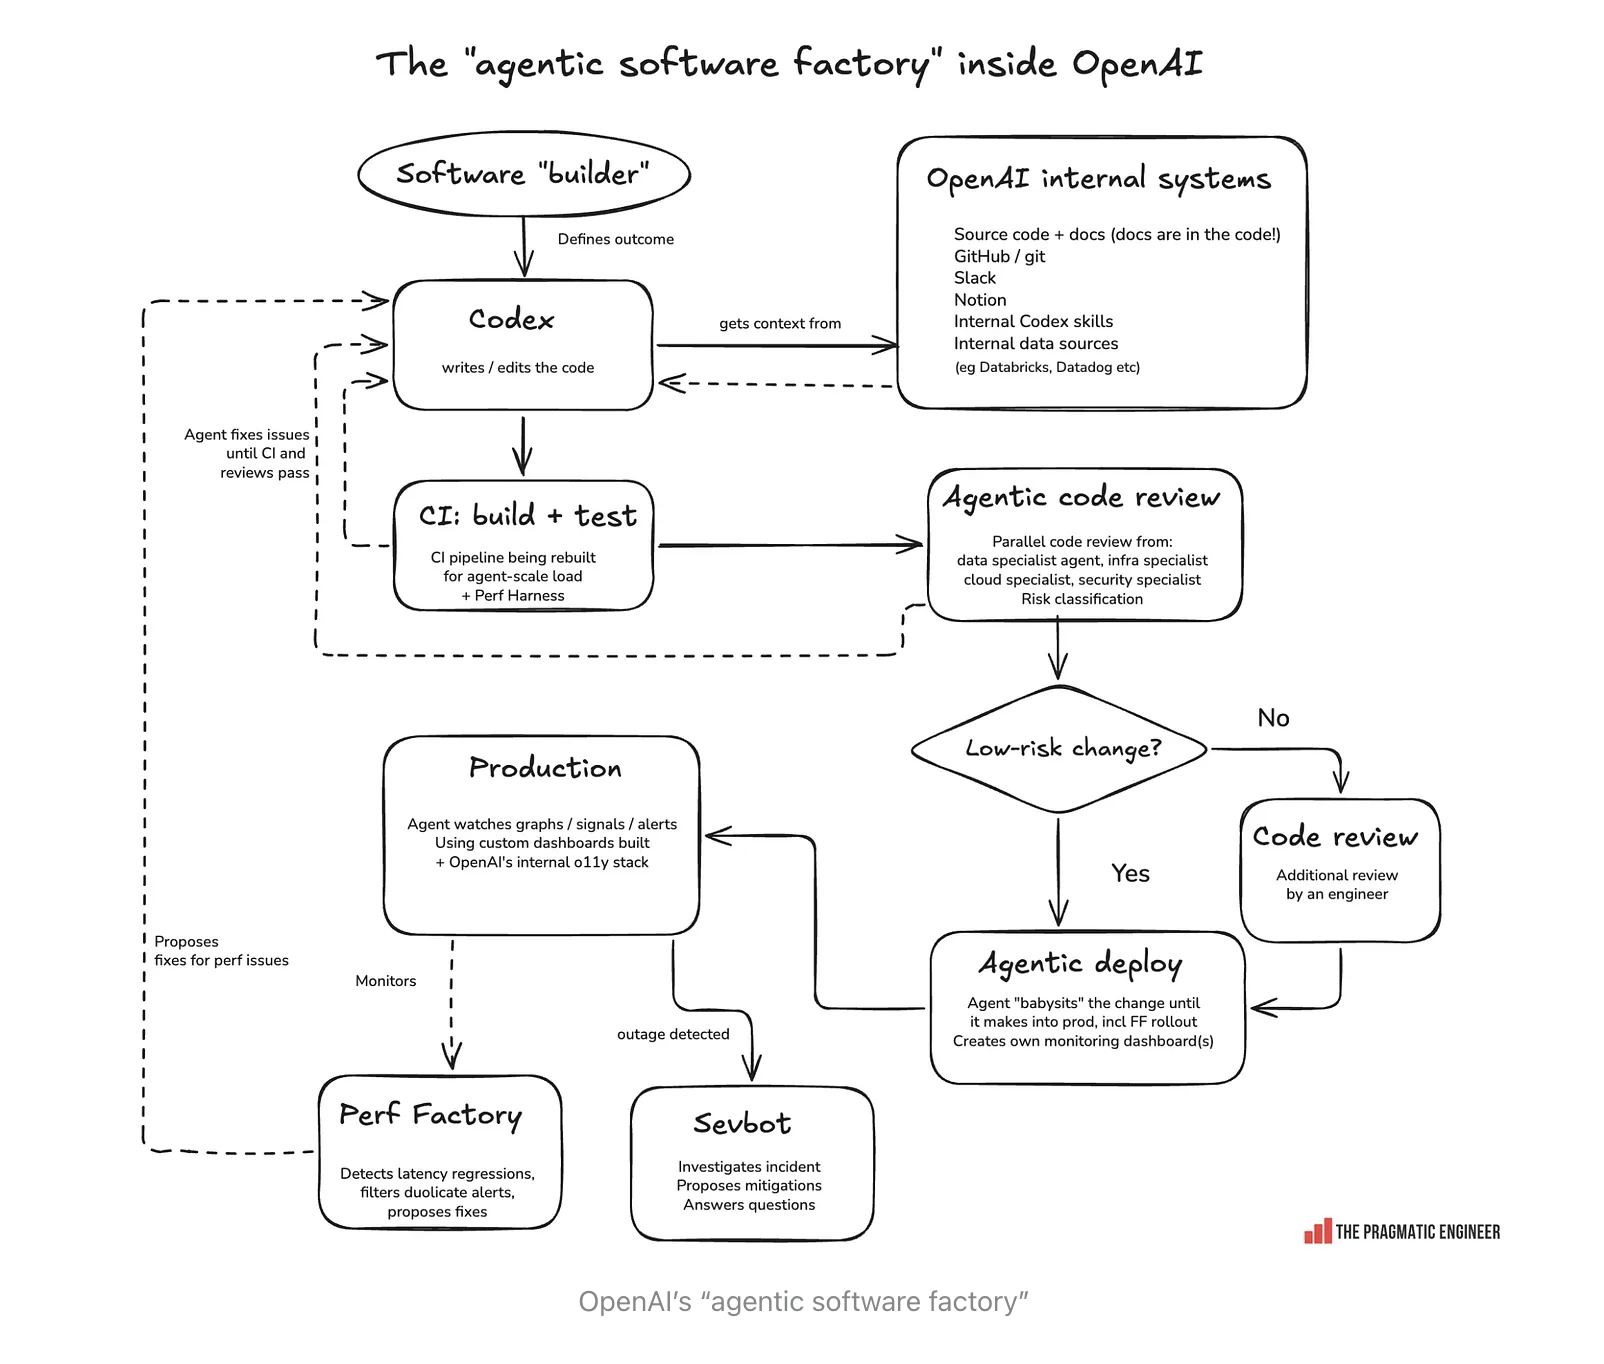
De maneira geral, imagino um fluxo assim:
- Uma demanda chega, com um resultado esperado claro.
- Agentes entendem a mudança e envolvem um humano caso precisem de mais clarificações.
- Agentes implementam a mudança e executam as verificações necessárias.
- Outros agentes revisam o resultado e procuram problemas.
- Humanos participam quando o risco, a importância da mudança ou a incerteza exigirem.
- A mudança é entregue gradualmente.
- Agentes acompanham o comportamento em produção.
- Se algo dá errado, os mecanismos de proteção limitam o impacto e fazem rollback quando aplicável.
- O problema vira uma nova demanda e uma oportunidade de melhorar a verificação.
E o ciclo continua.
Construir essa fábrica será um trabalho central dos times de plataforma em um futuro breve, em parceria com os times que conhecem o produto e suas regras de negócio. Precisamos oferecer ambientes em que agentes consigam trabalhar, contexto que consigam consultar, verificações que consigam executar e sinais de produção que consigam interpretar. Precisamos também definir onde podem atuar sozinhos e onde o julgamento humano continua necessário.
Não é algo que se resolve apenas comprando uma licença de um agente de código. Boa parte do trabalho está em codificar o que o time sabe sobre desenvolver e operar aquele sistema, tornar esse conhecimento utilizável e melhorar os mecanismos conforme aprendemos.
Conclusão
A engenharia de software agêntica veio para ficar. Os ganhos de produtividade já estão acontecendo, mas precisamos fazer nossa capacidade de verificar o software crescer junto com a capacidade de produzi-lo. Quanto mais evidência conseguimos reunir de que uma mudança funciona, mais autonomia podemos dar aos agentes.
A IA consegue escrever código de qualidade. Cabe ao time definir o que “qualidade” significa naquele contexto, oferecer bons exemplos e criar verificações para preservar as propriedades importantes. Na revisão, precisamos priorizar as mudanças que realmente exigem julgamento humano e transformar os problemas encontrados em melhorias na fábrica. Corrigir o erro de hoje é necessário; ensinar o agente a evitar o mesmo erro amanhã faz esse aprendizado se multiplicar.
Os testes precisam nos ajudar a verificar o comportamento que importa para o usuário. Uma suíte verde vale pouco se apenas confirma as mesmas decisões erradas da implementação. Testes de componente, integração e end-to-end ganham importância, assim como os ambientes e as ferramentas que permitem ao agente exercitar o sistema por conta própria. E essa verificação continua depois do deploy, com observabilidade, feature flags, rollouts parciais e mecanismos de recuperação que limitem o impacto dos problemas que escaparem.
Qualidade também inclui criar um produto que as pessoas queiram usar. Implementar mais funcionalidades não garante uma experiência melhor. Precisamos desenvolver bom gosto, escolher o que vale a pena construir e refinar o resultado. Isso continua exigindo atenção de engenharia, produto e design.
O trabalho dos times de plataforma será conectar essas peças em uma fábrica que consiga implementar, verificar, entregar e acompanhar mudanças, aprendendo com o que acontece em produção. Nosso julgamento continua fundamental para decidir o que essa fábrica deve produzir e quais evidências precisamos exigir para confiar nela.
Referências
- Attention Is All You Need.
- Search-Based Test Data Generation for SQL Queries.
- Search-Based Software Re-Modularization: A Case Study at Adyen.
- The Effectiveness of Supervised Machine Learning Algorithms in Predicting Software Refactoring.
- An Exploratory Study of Log Placement Recommendation in an Enterprise System.
- Data-Driven Extract Method Recommendations: A Study at ING.
- Learning Off-By-One Mistakes: An Empirical Study.
- Stripe — Minions: Stripe’s one-shot, end-to-end coding agents.
- Engenharia agêntica e vibe coding na Alura — Hipsters.tech #517.
- Laura Tacho — Benchmarks da DX no Pragmatic Summit.
- Anthropic — An update on recent Claude Code quality reports.
- Addy Osmani — Agentic Verification.
- Kent Beck — Código e confiança.
- Lauren (@poteto) — Qualidade de código e contexto.
- Dave Farley — Manutenção de código humano e gerado por IA.
- Maurício Aniche — Agentes de IA no código aberto: uma síntese do MSR 2026.
- Alura — Como migramos do Spring Boot 2 para o 4 com ajuda de IA.
- Anthropic — Effective context engineering for AI agents.
- Praveen Neppalli — Adoção de agentes de código na Uber.
- DHH — Revisão de mudanças feitas por designers no Basecamp.
- Guillermo Rauch — Leitura de código e autonomia dos agentes.
- Robert C. Martin — Métricas e testes para código gerado por agentes.
- Rachel Laycock — Maybe We Shouldn’t Be Reviewing All This Code.
- Will Larson — Speeding up code review with small-change.
- Tobias Lütke — Slop grenades, em The Knowledge Project.
- Brian Scanlan — Manutenção das instruções e das ferramentas dos agentes.
- Boris Cherny — Mudanças no perfil dos bugs produzidos por LLMs.
- Chris Evans — Volume de código e taxa de incidentes na incident.io.
- Luiz Henrique de Souza, iFood. Deploy Canário com Guardrails Automatizados. CBSoft 2026.
- Datadog — Bits AI SRE.
- DHH — Design, UX e estética.
- Ethan Eismann — Taste is what doesn’t change.
- Chris Kelly — The engineer’s guide to building a software factory.
- Gergely Orosz — Inside OpenAI’s agentic software factory.